




- Gemini 4 Argon là gì?
- Gemini 4 Argon có gì mới? 4 nâng cấp chính
- Gemini 4 Argon so với GPT-6 Astra và Claude: mạnh hơn ở đâu, kém ở đâu?
- Vì sao Google giao Gemini 4 Argon cho chuyên gia bảo mật trước?
- 3 cách Google đang dùng Gemini 4 Argon trong nội bộ
- 4 lớp bảo vệ an toàn của Gemini 4 Argon
- Giá Gemini 4 Argon bao nhiêu?
- Khi nào bạn dùng được Gemini 4 Argon?
- Gemini 4 Argon phù hợp với ai?
- Câu hỏi thường gặp về Gemini 4 Argon
Ngày 30/9/2026, Google DeepMind chính thức công bố Gemini 4 Argon, mô hình AI frontier thế hệ mới với khả năng mở rộng giới hạn output từ 64K lên đến 1 triệu token. Trong chuỗi 18 bài benchmark kiểm thử hiệu năng do Google công bố, Argon xuất sắc dẫn đầu 13 bài, bao gồm 1 bài ghi nhận kết quả đồng hạng nhất. Điểm bất ngờ là Gemini 4 Argon chưa mở rộng cho người dùng phổ thông mà được ưu tiên giao trước cho các chuyên gia bảo mật. Cùng Minh Tuấn Mobile tìm hiểu thông số chi tiết, so sánh hiệu năng, bảng giá và thời điểm mô hình AI này khả dụng.
Gemini 4 Argon là gì?
Gemini 4 Argon là mô hình AI frontier mới nhất của Google DeepMind, được thiết kế để suy luận sâu trong các tác vụ dài, nhiều bước như lập trình, tài chính, pháp lý và phòng thủ an ninh mạng.
| Mục | Thông tin |
| Nhà phát triển | Google DeepMind |
| Ngày công bố | 30/9/2026 |
| Output tối đa | 1 triệu token (trước đây là 64K) |
| Benchmark | Đứng đầu 13/18 bài Google công bố |
| Giá ưu đãi | $2 input / $10 output cho mỗi 1 triệu token |
| Ai đang dùng được | Chuyên gia bảo mật trong Fairwind Program |
Gemini 4 Argon có gì mới? 4 nâng cấp chính
Bốn nâng cấp dưới đây xếp theo mức độ khác biệt so với các bản Gemini trước.
Output tối đa 1 triệu token, gấp khoảng 15 lần trước đây
Khác với khái niệm cửa sổ ngữ cảnh đầu vào, Gemini 4 Argon mở rộng dung lượng đầu ra lên mốc 1 triệu token. Nâng cấp này cho phép mô hình duy trì chuỗi suy luận liên tục và sinh ra toàn bộ lượng mã nguồn hoặc tài liệu phân tích khổng lồ chỉ trong một lần phản hồi duy nhất.
Lập trình trên dự án thật, kéo dài nhiều bước
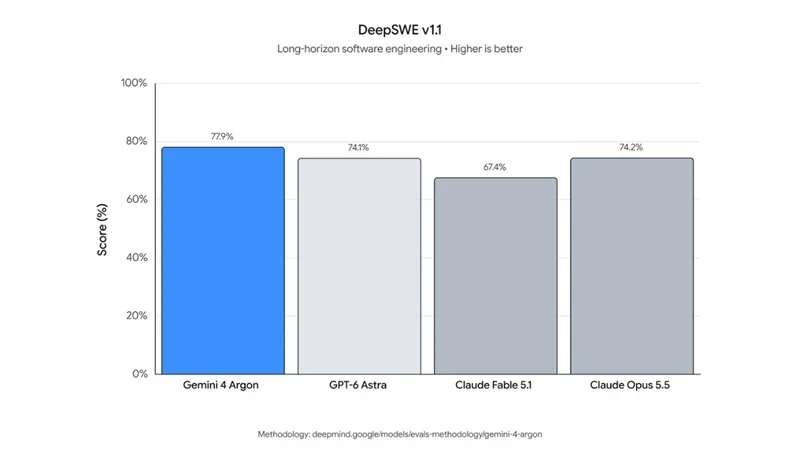
Ở tác vụ phát triển phần mềm thực tế, Gemini 4 Argon thiết lập trạng thái kỷ lục mới trên bài kiểm thử DeepSWE v1.1 với độ chính xác đạt 77,9% (vượt qua Claude Opus 5.5 với 74,2% và GPT-6 Astra đạt 74,1%). Trong môi trường đánh giá Vibe Code Bench, Argon ghi nhận kết quả 91,9%. Dù vậy, hiệu năng lập trình thực tế của mô hình vẫn thể hiện sự chênh lệch tùy theo từng dạng môi trường thao tác.
Xử lý công việc chuyên môn: tài chính, pháp lý, tự động hóa
Mô hình thể hiện ưu thế rõ rệt khi giải quyết các công việc tri thức phức tạp. Trên bảng xếp hạng Vals Index, Argon vươn lên vị trí dẫn đầu (1/41) với 68,9%. Các chỉ số đánh giá chuyên ngành khác bao gồm Vals Finance Agent v2 đạt 65,4% và AutomationBench đạt 51,3%. Đặc biệt, ở bài kiểm tra pháp lý Harvey Legal, Argon đạt 19,6%, cao gần gấp 3 lần so với đối thủ gần nhất dù mới hoàn thành khoảng 1/5 tổng số tác vụ.
Hiểu biểu đồ, tài liệu và video dài
Gemini 4 Argon tối ưu hóa khả năng phân tích đa phương thức với dữ liệu độ dài lớn. Mô hình đạt 91,7% trên bài test video độ dài lớn LVBench và ghi nhận 71,6% ở khả năng phân tích biểu đồ chuyên sâu Chartography.
Gemini 4 Argon so với GPT-6 Astra và Claude: mạnh hơn ở đâu, kém ở đâu?
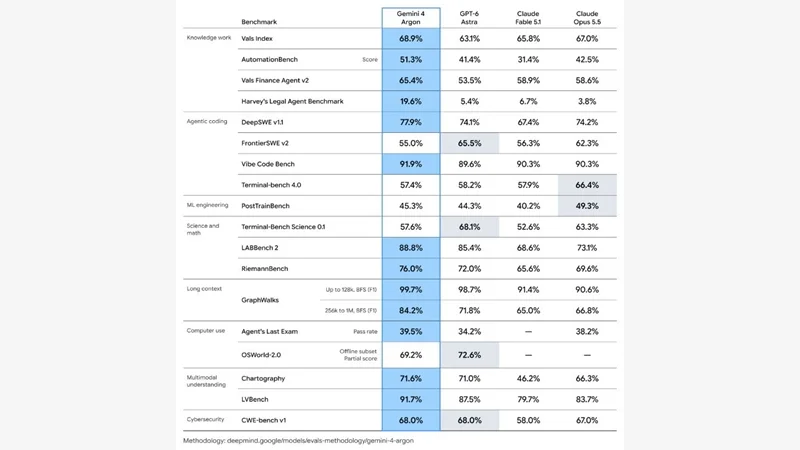
Trong 18 benchmark Google công bố, Argon dẫn đầu 12 bài, đồng hạng nhất 1 bài (CWE-bench v1) và xếp sau đối thủ ở 5 bài, chủ yếu là tác vụ lập trình chạy qua terminal.
12 benchmark Gemini 4 Argon dẫn đầu (xếp theo chênh lệch, từ lớn đến nhỏ)
| Benchmark | Argon | Đối thủ gần nhất | Chênh lệch |
| Harvey's Legal Agent (pháp lý) | 19,6% | Fable 5.1: 6,7% | +12,9 |
| GraphWalks 256K–1M (ngữ cảnh dài)* | 84,2% | Astra: 71,8% | +12,4 |
| AutomationBench (tự động hóa) | 51,3% | Opus 5.5: 42,5% | +8,8 |
| Vals Finance Agent v2 (tài chính) | 65,4% | Fable 5.1: 58,9% | +6,5 |
| LVBench (video dài) | 91,7% | Astra: 87,5% | +4,2 |
| RiemannBench (toán) | 76,0% | Astra: 72,0% | +4,0 |
| DeepSWE v1.1 (lập trình) | 77,9% | Opus 5.5: 74,2% | +3,7 |
| LABBench 2 (khoa học) | 88,8% | Astra: 85,4% | +3,4 |
| Vals Index (công việc tri thức) | 68,9% | Opus 5.5: 67,0% | +1,9 |
| Vibe Code Bench (lập trình) | 91,9% | Fable 5.1 / Opus 5.5: 90,3% | +1,6 |
| Agent's Last Exam (điều khiển máy tính) | 39,5% | Opus 5.5: 38,2% | +1,3 |
| Chartography (đọc biểu đồ) | 71,6% | Astra: 71,0% | +0,6 |
*GraphWalks có mốc input 128K: Argon 99,7%, Astra 98,7% (tính chung 1 benchmark).
5 benchmark Gemini 4 Argon xếp sau
| Benchmark | Argon | Model dẫn đầu | Chênh lệch | Hạng của Argon |
| FrontierSWE v2 | 55,0% | Astra: 65,5% | −10,5 | 4/4 |
| Terminal-Bench Science 0.1 | 57,6% | Astra: 68,1% | −10,5 | 3/4 |
| Terminal-bench 4.0 | 57,4% | Opus 5.5: 66,4% | −9,0 | 4/4 |
| PostTrainBench | 45,3% | Opus 5.5: 49,3% | −4,0 | 2/4 |
| OSWorld-2.0 | 69,2% | Astra: 72,6% | −3,4 | 2/2 |
Có thể thấy, Argon tạo khoảng cách lớn so với các đối thủ ở mảng xử lý công việc tri thức và ngữ cảnh siêu dài với mức chênh lệch từ 6 đến 13 điểm. Ở các tác vụ lập trình cơ bản và đa phương thức, Argon duy trì thế dẫn trước sát nút. Tuy nhiên, điểm yếu của Argon xuất hiện ở các tác vụ agent chạy trực tiếp qua giao diện dòng lệnh terminal. Theo kết quả độc lập từ Artificial Analysis, Argon nhận mức điểm 53, ngang hàng với GPT-6 Astra.
Vì sao Google giao Gemini 4 Argon cho chuyên gia bảo mật trước?
Vì Argon có thể tự tìm, xác thực và vá lỗ hổng nghiêm trọng. Năng lực này rất có ích cho phòng thủ nhưng cần được kiểm soát trước khi mở rộng.
Phiên bản không giới hạn tính năng bảo mật cho đối tác tin cậy (Fairwind Program)
Google triển khai chương trình Fairwind Program nhằm cung cấp phiên bản Argon đã được gỡ bỏ các rào cản phòng thủ mạng cho các đối tác an ninh được ủy quyền, hỗ trợ họ khai thác tối đa năng lực phát hiện mối đe dọa.
Phát hiện lỗ hổng trong phần mềm bệnh viện cùng Wiz
Thông qua sáng kiến Scan for Good kết hợp với Wiz, mô hình đã quét và phát hiện ra lỗ hổng an ninh nghiêm trọng làm rò rỉ dữ liệu cá nhân trên hệ thống phần mềm quản lý y tế tại nhiều bệnh viện, giải quyết mối nguy mà các mô hình cũ bỏ sót.
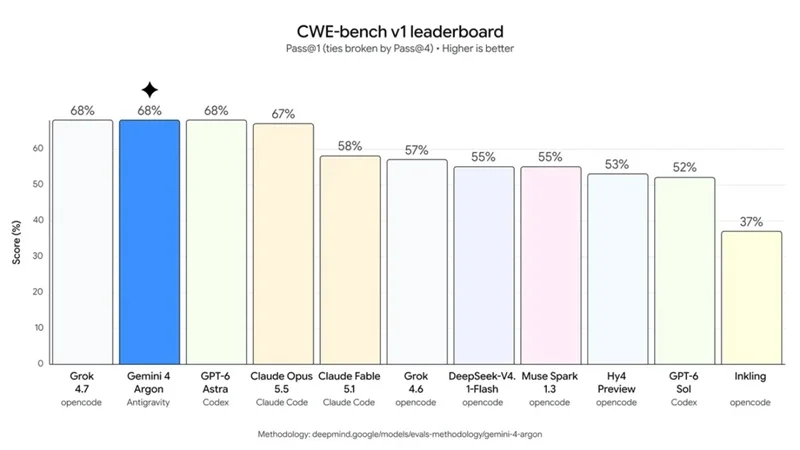
Đồng hạng nhất CWE-bench v1 với 68%
Ở thử nghiệm khắc phục lỗ hổng an ninh CWE-bench v1, ba mô hình Argon, GPT-6 Astra và Grok 4.7 cùng chia nhau vị trí dẫn đầu với 68%. Mỗi hệ thống được chạy trên hạ tầng agent riêng: Argon sử dụng Antigravity, GPT sử dụng Codex, Claude chạy trên Claude Code và các mô hình còn lại vận hành qua opencode.
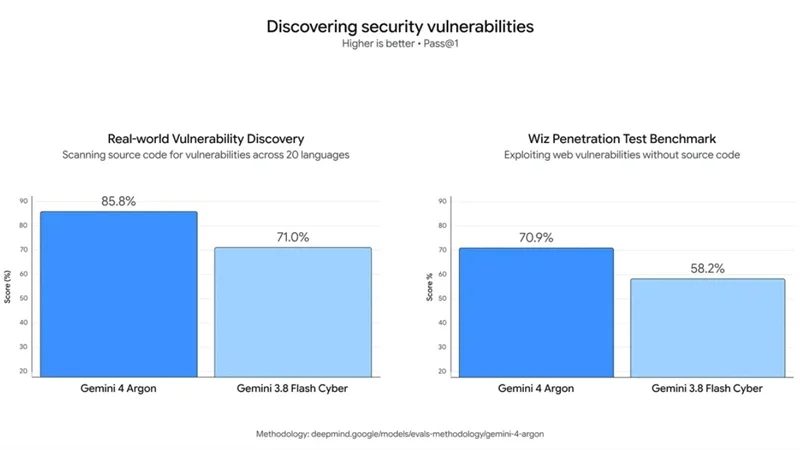
Tìm lỗ hổng tốt hơn Gemini 3.8 Flash Cyber
| Benchmark | Argon | 3.8 Flash Cyber |
| Quét mã nguồn tìm lỗ hổng (20 ngôn ngữ) | 85,8% | 71,0% |
| Pentest web của Wiz (không có mã nguồn) | 70,9% | 58,2% |
3 cách Google đang dùng Gemini 4 Argon trong nội bộ
Hệ thống AI này đã được ứng dụng trực tiếp vào quy trình vận hành và hạ tầng kỹ thuật tại Google.
Tối ưu thuật toán lượng tử
Sử dụng Argon giúp các nhà nghiên cứu tính toán tối ưu hóa tài nguyên thuật toán lượng tử, vượt qua các mốc cơ sở công bố trước đó 40% chỉ trong vài phút xử lý.
Giải phóng bộ nhớ trung tâm dữ liệu
Các agent Argon phân tích dữ liệu vi mô trên toàn hệ thống hạ tầng, tự động thực thi tối ưu hóa bộ nhớ và giải phóng hơn 300 TiB bộ nhớ thực tế, ước tính tổng mức tiết kiệm đạt từ 500 TiB đến 1 PiB.
Chuyển code C/C++ sang Rust
Argon tham gia tái cấu trúc các kho mã nguồn từ C/C++ sang Rust (bao gồm re2, libgav1 và nhân Fuchsia Zircon). Với trình giải mã video libgav1, việc tối ưu hóa giúp mã nguồn Rust chạy nhanh gấp 2,7 lần so với bản gốc.
4 lớp bảo vệ an toàn của Gemini 4 Argon
Để đảm bảo an toàn triển khai, Google thiết lập 4 cơ chế kiểm soát rủi ro:
Chặn lạm dụng cho tấn công mạng và vũ khí CBRN
Mô hình được huấn luyện để từ chối các yêu cầu hỗ trợ tấn công an ninh mạng hoặc chế tạo vũ khí hóa học, sinh học, phóng xạ và hạt nhân (CBRN).
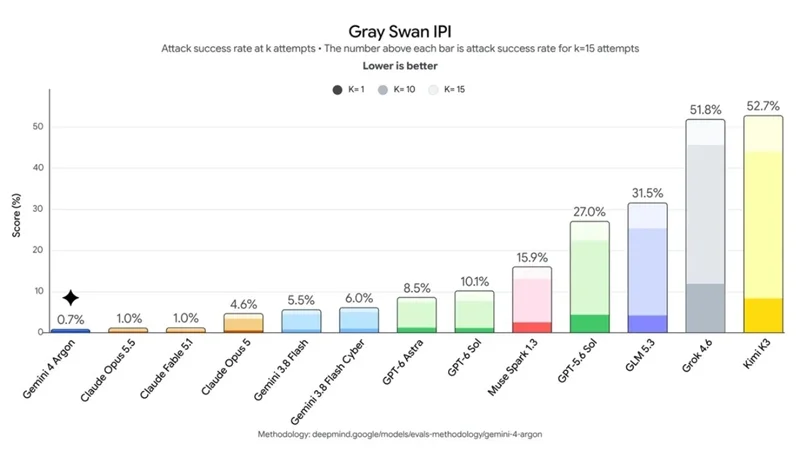
Chống prompt injection gián tiếp
Argon được gia cố khả năng chống lại các cuộc tấn công chèn lệnh gián tiếp. Trên bảng đánh giá Gray Swan IPI, tỷ lệ tấn công thành công vào Argon chỉ dừng ở mốc 0,7% (so với Claude Opus 5.5/Fable 5.1 là 1,0%, Gemini 3.8 Flash là 5,5% và GPT-6 Astra là 8,5%).
Giám sát chuỗi suy luận để chặn hành vi vượt ý định người dùng
Hệ thống giám sát liên tục chuỗi suy luận (chain-of-thought) và các thao tác của Argon, tự động ngắt lệnh nếu phát hiện mô hình thực thi sai lệch so với mục tiêu ban đầu của người dùng.
Cô lập sandbox trước khi huấn luyện và đánh giá rủi ro cao
Các quá trình thử nghiệm đánh giá rủi ro được thực thi trong môi trường sandbox cô lập an toàn nghiêm ngặt nhằm tránh các sự cố phát sinh.
Giá Gemini 4 Argon bao nhiêu?
Google công bố bảng giá sử dụng API dành cho Gemini 4 Argon với chi phí tối ưu:
| Loại token (giá cho 1 triệu token) | Giá ưu đãi | Giá sau ưu đãi |
| Input | $2 | $4 |
| Output | $10 | $20 |
| Cached input (giảm 95%) | $0,10 | $0,20 |
Khi nào bạn dùng được Gemini 4 Argon?
Lộ trình phát hành của Google được chia thành 4 giai đoạn cụ thể:
- Chuyên gia bảo mật trong Fairwind Program: Nhóm đối tác được truy cập đầu tiên.
- Nhóm thử nghiệm tin cậy: Mở rộng trải nghiệm và thu thập phản hồi.
- Khách hàng API trả phí và người dùng gói Google AI Ultra: Được đăng ký trải nghiệm tiếp theo.
- Lập trình viên, doanh nghiệp và người dùng phổ thông: Tiếp cận sau khi hoàn thiện các lớp rào chắn an toàn.
Gemini 4 Argon phù hợp với ai?
Dựa trên dữ liệu thử nghiệm, các nhóm đối tượng sau đây sẽ khai thác hiệu quả nhất năng lực của Argon:
- Doanh nghiệp tài chính, pháp lý: Đây là mảng chứng kiến sự áp đảo lớn nhất của Argon về khả năng phân tích dữ liệu.
- Dev làm việc với codebase lớn: Phù hợp với các dự án lớn nhờ điểm DeepSWE cao, tuy nhiên nếu cần chạy agent qua terminal thì GPT-6 Astra hay Claude Opus 5.5 vẫn nhỉnh hơn.
- Đội bảo mật: Nhóm người dùng được ưu tiên tiếp cận mô hình sớm nhất.
- Người dùng phổ thông: Nên kiên nhẫn chờ đợi bản phát hành rộng rãi chính thức.
Câu hỏi thường gặp về Gemini 4 Argon
Dưới đây là phần giải đáp cho những thắc mắc phổ biến về mô hình AI mới của Google:
Gemini 4 Argon có miễn phí không?
Hiện tại mô hình chưa cung cấp miễn phí cho công chúng. Người dùng API sẽ trả phí theo lượng token tiêu thụ, trong khi người dùng cá nhân cần đăng ký gói Google AI Ultra khi mô hình được tích hợp.
Gemini 4 Argon dùng được ở Việt Nam chưa?
Mô hình hiện chỉ khả dụng giới hạn cho các tổ chức bảo mật thuộc chương trình Fairwind Program. Người dùng tại Việt Nam có thể truy cập qua cổng Google AI Studio hoặc Vertex AI khi Google mở rộng giai đoạn phát hành API.
Fairwind Program là gì?
Fairwind Program là chương trình thử nghiệm của Google DeepMind dành riêng cho các chuyên gia và tổ chức phòng thủ an ninh mạng tin cậy nhằm kiểm thử và ứng dụng sớm khả năng bảo vệ của AI.
 Minh Tuấn Mobile















Mời bạn cùng thảo luận